
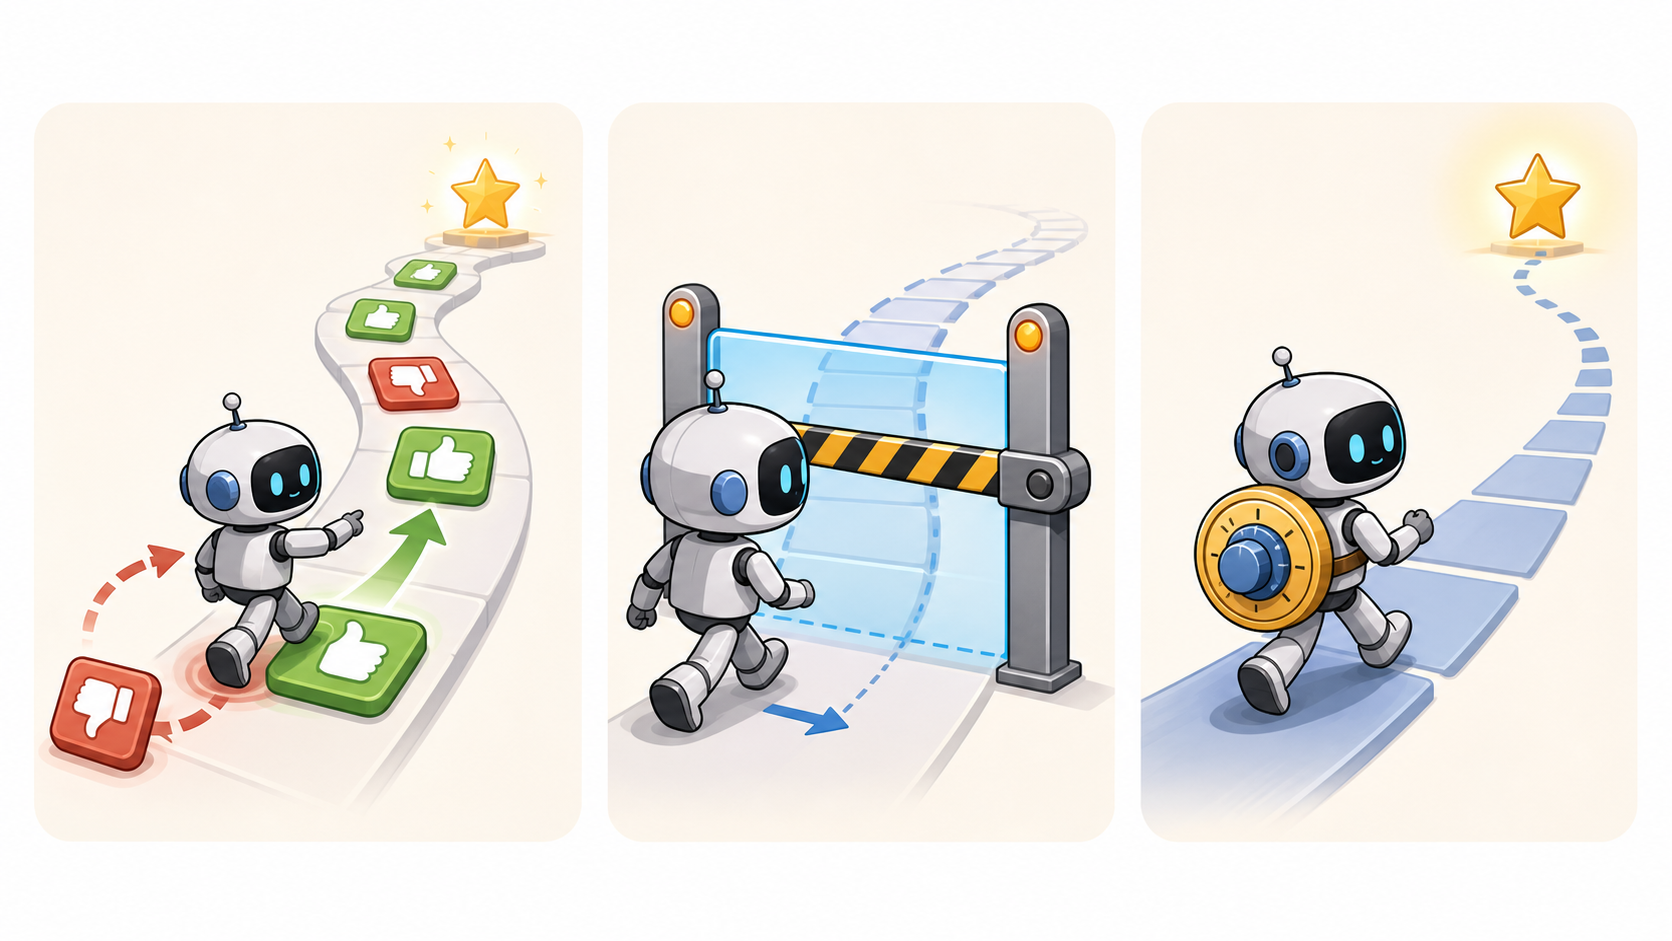
- 左边:Importance Sampling。模型走过一串 token,有的选择被奖励,有的选择被惩罚;loss 的工作就是把好选择的概率推高,把坏选择的概率压低。
- 中间:PPO。模型不能因为一次奖励就猛冲,clip 像限速门,防止一步改太大。
- 右边:CISPO。clip 后的 ratio 像一个固定砝码,只调节梯度大小;真正被优化的是当前 token 的
logprob。
接下来,我将开启我的强化学习算法分享之路,因为最近在用 pytrio 研究强化学习算法,感觉很有趣,似乎找到了最原始的快乐哈哈哈。之前我想研究agent-rl, 发现如果用verl的话,需要训推一体,然后至少一个4卡或者8卡的节点。然后发现 pytrio 不需要管这些,然后我可以潜心研究或者复现当前论文的强化学习算法。所以我打算开启一个复现10篇论文的强化学习算法分享Blog,我会开源所有的代码,然后代码都会使用pytrio来复现。复现的算法包括但不限于GRPO、GSPO、DAPO、OPD等各种变体的OPD!
今天是分享的第零篇,强化学习基础-损失函数篇。
很多人第一次看强化学习 loss,会有一个很自然的困惑:监督学习的 loss 我能理解,答案对不上就惩罚;可强化学习里,模型自己生成了一段话,后面才拿到一个 reward,那 loss 到底在优化什么?
我的理解是,先不要把它想成复杂公式。强化学习里的很多 loss,本质是在做一件事:
如果某些 token 后来被证明对结果有帮助,就让模型下次更容易生成它们;如果某些 token 拖了后腿,就让模型下次少生成它们。
这件事拆开之后,就会出现三个变量:
advantage:这一步是好是坏。sampling_logprobs:生成答案时,采样模型当时有多喜欢这个 token。target_logprobs:训练时,当前模型现在有多喜欢这个 token。
用这三个东西,就能理解 Importance Sampling、PPO 和 CISPO 的区别。
1. Importance Sampling
Importance Sampling 最直接。它问的是:当前模型和采样模型对同一个 token 的概率比例是多少?
实现时再把概率比例写成 exp(target_logprobs - sampling_logprobs),并因为优化器最小化 loss,所以代码里加负号:
prob_ratio = torch.exp(target_logprobs - sampling_logprobs)
loss = -(prob_ratio * advantages).sum()
如果 advantage 是正的,说明这个 token 有用,训练会推高它的概率。
如果 advantage 是负的,说明这个 token 没用,训练会压低它的概率。
这里的负号只是因为优化器默认最小化 loss。我们真正想最大化的是 ratio * advantage 这个目标。
2. PPO
PPO 解决的是另一个问题:如果 ratio 太大,模型可能一次更新就走太远。
所以 PPO 给 ratio 加了一个 clip:
比如一个 token 的 advantage 很高,ratio 已经到了 1.8,说明当前模型已经比采样时更喜欢它很多。PPO 不会继续按 1.8 的力度推,而是把它限制到比如 1.2。这就是 PPO 的核心直觉:可以学习,但别一步冲太远。
3. CISPO
CISPO 和 PPO 的区别更细一点。
PPO 是 clip objective。
CISPO 是 clip ratio,然后把这个 ratio 当成固定系数,去乘 logprob * advantage。
这里最关键的是 detach。它表示 clipped ratio 不再参与梯度回传,只作为一个固定权重。真正被优化的是 target_logprob。
所以 CISPO 可以理解成:给每个 token 的学习力度加一个上限,但不直接把某些 token 的梯度剪没。
4. 一句话比较
| Loss | 人话比喻 | 核心动作 | 最容易误解的点 |
|---|---|---|---|
| Importance Sampling | 按功劳发奖金 | ratio * advantage | loss 可能为负,这是因为代码在最小化负目标 |
| PPO | 奖金有预算上限 | min(unclipped, clipped) | min 不是随便取小,而是在做保守更新 |
| CISPO | 给学习力度挂固定砝码 | detach(clipped_ratio) * logprob * advantage | .detach() 后 ratio 不走梯度,主要是 logprob 在被优化 |
更短的总结:
IS:    有用就提高概率,没用就降低概率;ratio 负责修正采样偏差。
PPO:   还是这么做,但 ratio 不能太离谱,防止策略更新过猛。
CISPO: ratio 也会被 clip,但 clip 后只当固定权重,真正优化 logprob。